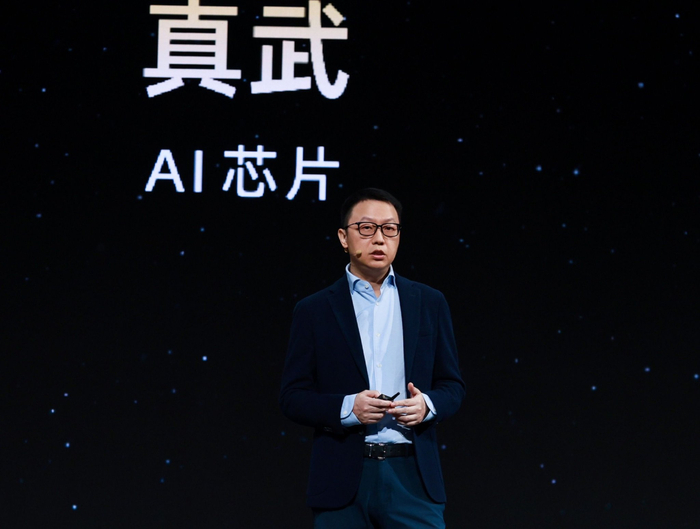
阿里巴巴吴泳铭:“机器智能”时代智能正在成为规模化商品
2026-09-22
 |用户侧智慧能源管理领航者 - AIoT驱动数字能源升级
很多人以为,智能配电系统的数据采集量越大,系统运行就越稳定,其实不然。数据采集的边界并非由设备性能单独决定,而是由系统架构、通信协议、数据处理能力共同构成的复杂函数。当数据采集量超过系统处理阈值时,反而会引发数据洪流效应,导致系统响应延迟甚至崩溃。这一现象在分布式能源接入场景中尤为明显——某省级电网2023年夏季用电高峰期间,因光伏逆变器数据上报频率过高,导致区域调度系统卡顿,最终通过动态调整数据上报周期才恢复稳定。

底层逻辑是:智能配电系统的稳定性取决于数据采集与处理的动态平衡。以IEC 61850标准为例,其规定的GOOSE报文传输周期最小为2ms,但实际工程中,为避免网络拥塞,通常会将周期设置为5-10ms。这种设计并非技术限制,而是基于对数据时效性与系统负载的权衡。某地级市配电自动化项目曾尝试将所有终端数据实时上传至主站,结果导致主站数据库负载激增,查询响应时间从毫秒级跃升至秒级,最终不得不回归分级存储策略。
2024年7月,长三角地区遭遇持续40℃以上高温,用电负荷连续5日突破历史峰值。某地市供电公司管辖的10kV配电网中,共有237台DTU(分布式终端单元)和1.2万只智能电表需上报数据。按原设计,所有终端每15秒上报一次运行数据,主站数据库单日新增数据量达800GB。7月15日14:00,系统突然报出“数据采集超限”错误,部分馈线自动化功能失效。
技术团队排查发现,问题根源在于数据采集策略未考虑负荷峰谷特性。在用电高峰时段,终端上报的数据量是低谷时段的3倍,而主站数据库的写入性能并未动态调整。更关键的是,大量冗余数据(如设备状态未变化时的重复上报)占用了宝贵带宽。例如,某条10kV线路的DTU在1小时内上报了3600次“开关位置正常”数据,而真正需要关注的“过流保护动作”信号仅出现1次。
修复方案包含三步:首先,将数据采集周期从固定15秒改为动态调整——高峰时段延长至30秒,低谷时段缩短至10秒;其次,引入数据过滤机制,仅上报状态变化或越限数据;最后,在主站侧部署边缘计算节点,对原始数据进行预处理后再上传。实施后,主站数据库单日数据量降至300GB,系统响应时间恢复至500ms以内,未再出现数据采集超限错误。
这一案例揭示了一个反直觉的事实:在智能配电系统中,减少数据采集量未必意味着信息缺失,反而可能通过优化数据结构提升系统可靠性。正如某省级电网调度中心主任所言:“我们需要的不是更多数据,而是更精准的数据。”当系统面临“没有更多数据了”的边界时,真正的挑战不是突破硬件限制,而是重新定义数据价值——哪些数据是必需的?哪些可以本地处理?哪些可以延迟上报?这些问题的答案,决定了智能配电系统能否在数据洪流中保持稳定运行。