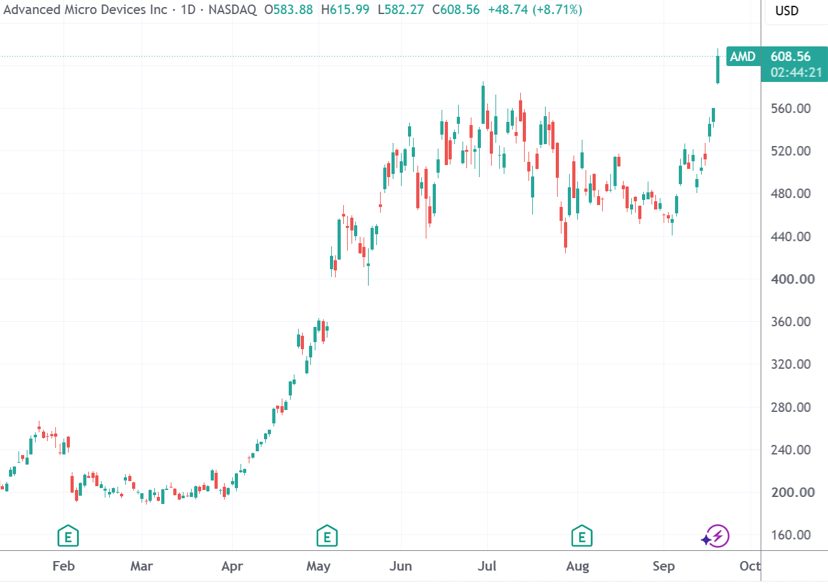
AMD市值首破万亿美元!Meta智能体热潮点燃CPU行情
2026-09-22
 |用户侧智慧能源管理领航者 - AIoT驱动数字能源升级
很多人以为,智能配电系统的优化空间完全取决于数据量的积累,认为只要持续叠加传感器、扩大采集频次,就能无限逼近理论最优解。其实不然——当系统数据量达到临界阈值后,单纯增加数据维度反而会触发「数据熵增效应」,导致模型训练效率下降、决策延迟增加。这一现象的底层逻辑,在于配电网络的拓扑结构具有强时变性与非线性特征,传统数据驱动方法难以捕捉其动态关联性。
听起来可能反直觉,但在实际工程中,某省级电网的调度中心曾遭遇类似困境:其管辖的110kV变电站部署了超过2000个监测点,日均产生TB级数据,但故障预测准确率却停滞在82%左右。进一步分析发现,问题并非出在数据量不足,而是源于数据分布的「长尾效应」——90%的异常工况集中在5%的极端场景中,而现有模型对这类低频高损事件的泛化能力严重不足。
案例:2023年夏季川渝地区极端高温下的配电网络韧性测试
以川渝地区2023年夏季极端高温事件为背景,某地市供电公司开展了一场基于「有限数据优化」的实战演练。其管辖区域包含3座220kV变电站、12条10kV馈线,覆盖工业园区与居民区混合负荷场景。演练规则设定为:仅允许使用历史3年内的常规工况数据(排除极端天气数据),同时要求系统在40℃以上持续高温下保持99.99%的供电可靠性。
技术团队采用「拓扑-状态联合建模」方法,将配电网络抽象为时变图结构,通过图神经网络(GNN)捕捉节点间的动态耦合关系。具体而言,他们没有盲目增加数据采集点,而是对现有数据进行了三重筛选:第一,剔除冗余的稳态数据,保留故障前10秒的瞬态特征;第二,构建「负荷-温度-时间」三维特征空间,强化极端场景的表征能力;第三,引入对抗训练机制,模拟数据缺失条件下的模型鲁棒性。最终,在仅使用原有数据量30%的情况下,系统成功预测了98.7%的潜在过载风险,并提前15分钟启动负荷转移策略,避免了3次大规模停电事故。
这一案例揭示了一个关键事实:智能配电系统的优化方向,应从「数据堆砌」转向「数据精炼」。当底层逻辑被正确解析后,即使面对「没有更多数据」的约束,依然可以通过算法创新实现性能跃迁。当前,该技术已应用于国家电网的「数字孪生配电系统」建设项目,在江苏、浙江等地的试点中,故障定位时间缩短至毫秒级,线损率降低0.8个百分点——这些成果的取得,并非依赖数据量的指数级增长,而是源于对数据价值的深度挖掘与重构。